ScrapeNinja, l'API di web scraping nata per aggirare Cloudflare che a fine 2023 incassava 8.000 $ al mese
Scheda redatta da Alexis Guay, aggiornata il .
ScrapeNinja è un’API per sviluppatori: si invia l’indirizzo di una pagina e si riceve l’HTML o i dati già estratti in JSON, senza doversi occupare di proxy, browser automatizzati e blocchi anti-bot. È nata da un problema preciso, aggirare la protezione di Cloudflare, ed è gestita da una persona sola. A ottobre 2023 il fondatore dichiarava 8.000 $ di ricavi ricorrenti mensili.
Cosa fa
Chi raccoglie dati dal web (prezzi dei concorrenti, annunci, cataloghi, documentazione da dare in pasto a un modello linguistico) si scontra presto con i blocchi. Molti siti riconoscono le richieste automatiche e rispondono con un errore. ScrapeNinja offre due motori. Il primo è leggero, simile a cURL, ma presenta al sito la stessa impronta TLS di un vero Chrome: è veloce ed economico. Il secondo apre un browser reale che esegue JavaScript, per le pagine che si costruiscono nel browser. Entrambi ruotano automaticamente i proxy, con la scelta del paese di uscita, e ripetono le richieste fallite.
Intorno all’API ci sono strumenti per chi deve ancora scrivere il proprio scraper: un costruttore online che genera codice in Node.js, Python e PHP, un ambiente per provare gli estrattori in JavaScript sull’HTML scaricato, estrattori che restituiscono la pagina in Markdown. C’è anche un nodo per n8n, la piattaforma di automazione, con un crawler ricorsivo pensato per raccogliere documentazione.
Chi c’è dietro
Anthony Sidashin, che firma come Anton nei testi in russo, è stato per oltre sette anni CTO di Qwintry, un servizio di spedizioni internazionali per acquisti online. Verso la fine del 2019 ha cominciato a costruire piccoli prodotti per conto suo. In un paio d’anni ha portato due API oltre i 10.000 e i 5.000 $ di ricavi mensili: la seconda è ScrapeNinja, la prima ha poi chiuso.
ScrapeNinja è nata nel 2021 da un sito che non riusciva a leggere. Nel browser la pagina si apriva, ma la stessa richiesta copiata come comando cURL riceveva un errore 403. Indagando ha capito che Cloudflare distingueva i client dall’impronta della connessione TLS. La soluzione è stata compilare una parte dello stack di rete di Chromium in C++ e richiamarla da Node.js: un comando che si usa come cURL ma che, per il sito, sembra Chrome. Alcune fonti citano anche il fratello Oleg come cofondatore; nei suoi testi Sidashin descrive ScrapeNinja come un prodotto di una persona sola.
Come guadagna
Abbonamenti mensili con quote di richieste, più un costo a consumo oltre la soglia. I piani, verificati a ottobre 2026 su RapidAPI, vanno da un livello gratuito (500 richieste semplici e 50 con browser al mese) a Pro a 25 $ per 100.000 richieste, Ultra a 75 $ e Mega a 150 $ per 1,5 milioni di richieste. Una richiesta con browser vale sette richieste semplici; dal 2025 gli estrattori più pesanti consumano punti aggiuntivi.
| Data | Ricavi dichiarati |
|---|---|
| Marzo 2023 | circa 5.000 $ al mese |
| Ottobre 2023 | 8.000 $ di MRR |
A marzo 2023 Sidashin diceva che la crescita si era fermata e che servivano nuovi canali. I costi erano bassi: circa 300 $ al mese per i server su Hetzner e i proxy in vari paesi. Il suo sito oggi parla di oltre 1.000 clienti, senza date né cifre di fatturato più recenti.
Da dove arrivano i clienti
Quasi tutti i primi clienti, racconta Sidashin, sono arrivati dalla ricerca organica e dal suo blog tecnico, Pixeljets, che scrive da più di dieci anni e che Google premia. Gli articoli su come aggirare Cloudflare o su come fare scraping con n8n portano esattamente il pubblico che usa il prodotto.
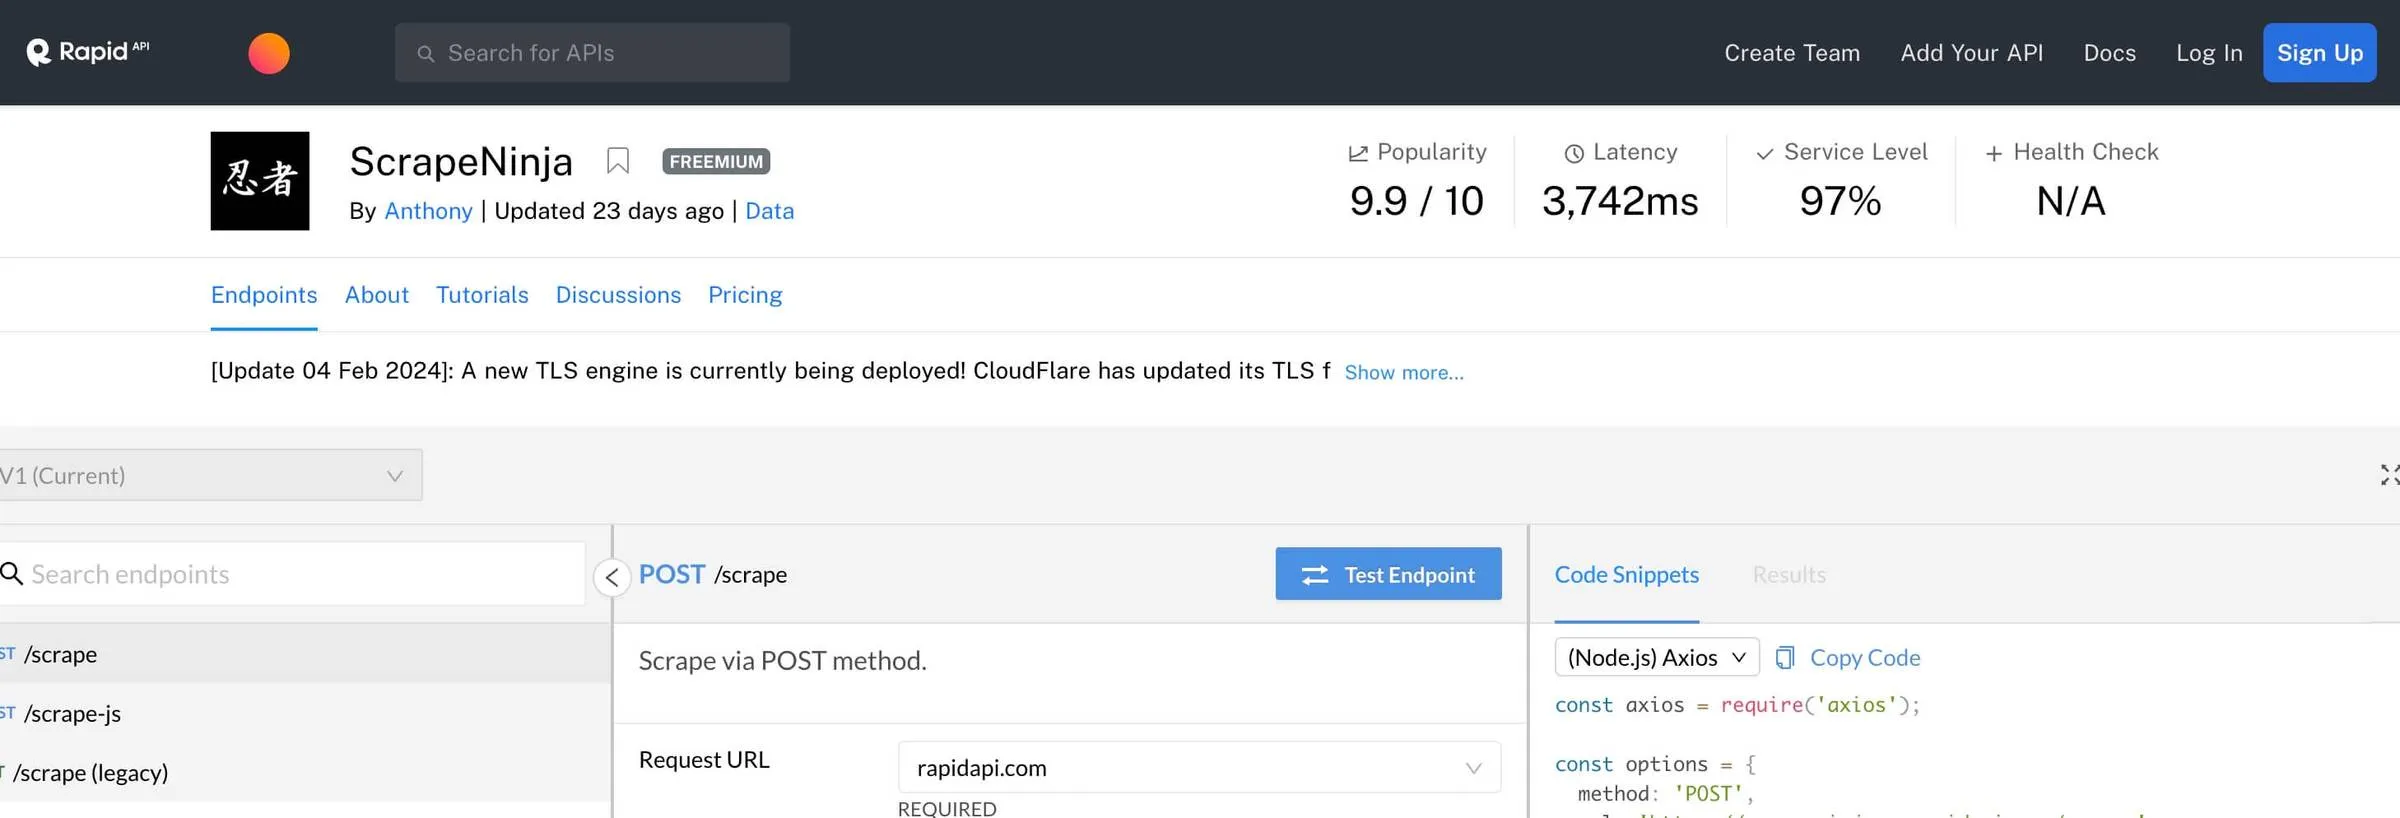
Il secondo canale sono i marketplace di API. ScrapeNinja è venduta su RapidAPI, dove molti sviluppatori cercano e pagano API senza visitare il sito del fornitore, e su APIRoad, un marketplace che Sidashin ha costruito lui stesso mentre combatteva con la fatturazione. Il nodo ufficiale per n8n e i modelli di automazione pubblicati nella libreria della piattaforma fanno da vetrina presso un pubblico tecnico affine.
Cosa si può copiare
- Il prodotto nasce da un problema tecnico vissuto in prima persona e risolto in un modo che i concorrenti non offrivano. Il racconto della soluzione è diventato anche il miglior contenuto di marketing.
- Un blog tecnico curato per anni è un canale che non si compra: porta clienti già convinti che chi scrive sa il fatto suo.
- Vendere sui marketplace di API toglie il lavoro di fatturazione e chiavi d’accesso e mette il prodotto davanti a chi sta già cercando.
- I margini restano alti solo se si controllano i costi variabili: proxy e browser costano, e il prezzo a punti (una richiesta con browser ne vale sette) li ribalta sul cliente.
In Italia
Sulla ricerca «servizio web scraping API estrarre dati da siti web senza essere bloccati» compaiono comparatori di prezzi in inglese, ScrapingBee, scrape.land e SmartProxy con una pagina tradotta in italiano. Non c’è un fornitore italiano tra i primi risultati, ma il prodotto generico è una commodity globale con concorrenti molto finanziati.
Lo spazio è nei dati italiani difficili da raccogliere. Gli albi pretori online dei comuni pubblicano delibere, bandi e avvisi su migliaia di siti diversi, ognuno con il suo formato. Un servizio che li normalizzi e mandi avvisi per parola chiave interesserebbe imprese che partecipano a gare, studi tecnici e giornalisti locali. Lo stesso vale per gli annunci immobiliari o i listini dei marketplace italiani, con l’avvertenza che il riuso di banche dati altrui va verificato caso per caso alla luce del diritto europeo sulle banche dati e del GDPR.
Fonti
- Reddit r/SaaS, il fondatore indica 8.000 $ di MRR (ottobre 2023)reddit.com
- Vas3k.club, Anton Sidashin racconta ScrapeNinja: 5.000 $ al mese e costi (marzo 2023, in russo)vas3k.club
- Pixeljets, blog del fondatore: Solo, bootstrapped, minimalpixeljets.com
- RapidAPI, piani e prezzi di ScrapeNinja (verificati a ottobre 2026)rapidapi.com
- APIRoad, scheda di ScrapeNinja con aggiornamenti 2025apiroad.net
Domande frequenti
Quanto guadagna ScrapeNinja?
A ottobre 2023 il fondatore indicava 8.000 $ di ricavi ricorrenti mensili. A marzo 2023 parlava di circa 5.000 $ al mese, con circa 300 $ di costi per server e proxy. Non ci sono cifre pubbliche più recenti.
Chi ha creato ScrapeNinja?
Anthony (Anton) Sidashin, sviluppatore ed ex CTO del servizio di spedizioni Qwintry. Lo ha avviato nel 2021 e lo descrive come un prodotto gestito da una sola persona.
Esiste un servizio simile in italiano?
Tra i risultati in italiano compare SmartProxy con una pagina tradotta. Gli altri sono servizi e comparatori in inglese, come ScrapingBee, Zyte e Bright Data.
Altri casi in API
Tutti i casi in API| Prodotto | Modello | Dal | Fatturato |
|---|---|---|---|
 Polotno SDKEditor grafico white-label da integrare nella propria app web | Abbonamento | 2020 | 60.000 $/mese |
 ScreenshotOneAPI che trasforma un URL o un HTML in immagine, PDF o video | Abbonamento | 2022 | 33.000 $/mese |
 TextbeltAPI minimale per inviare SMS da codice, senza account né abbonamento | A consumo | 2012 | 24.000 $/mese |
 PDFShiftAPI che converte documenti HTML in PDF e immagini | Abbonamento | 2018 | 21.000 $/mese |
 Holiday APIAPI con le festività di 250 paesi e 3.680 stati e province | Abbonamento | 2013 | 6.500 $/mese |